いいところだけ集めて、ひとつの音へ。
区間選択・配置などはAIなし。声の分離・変換には専用モデルを追加。
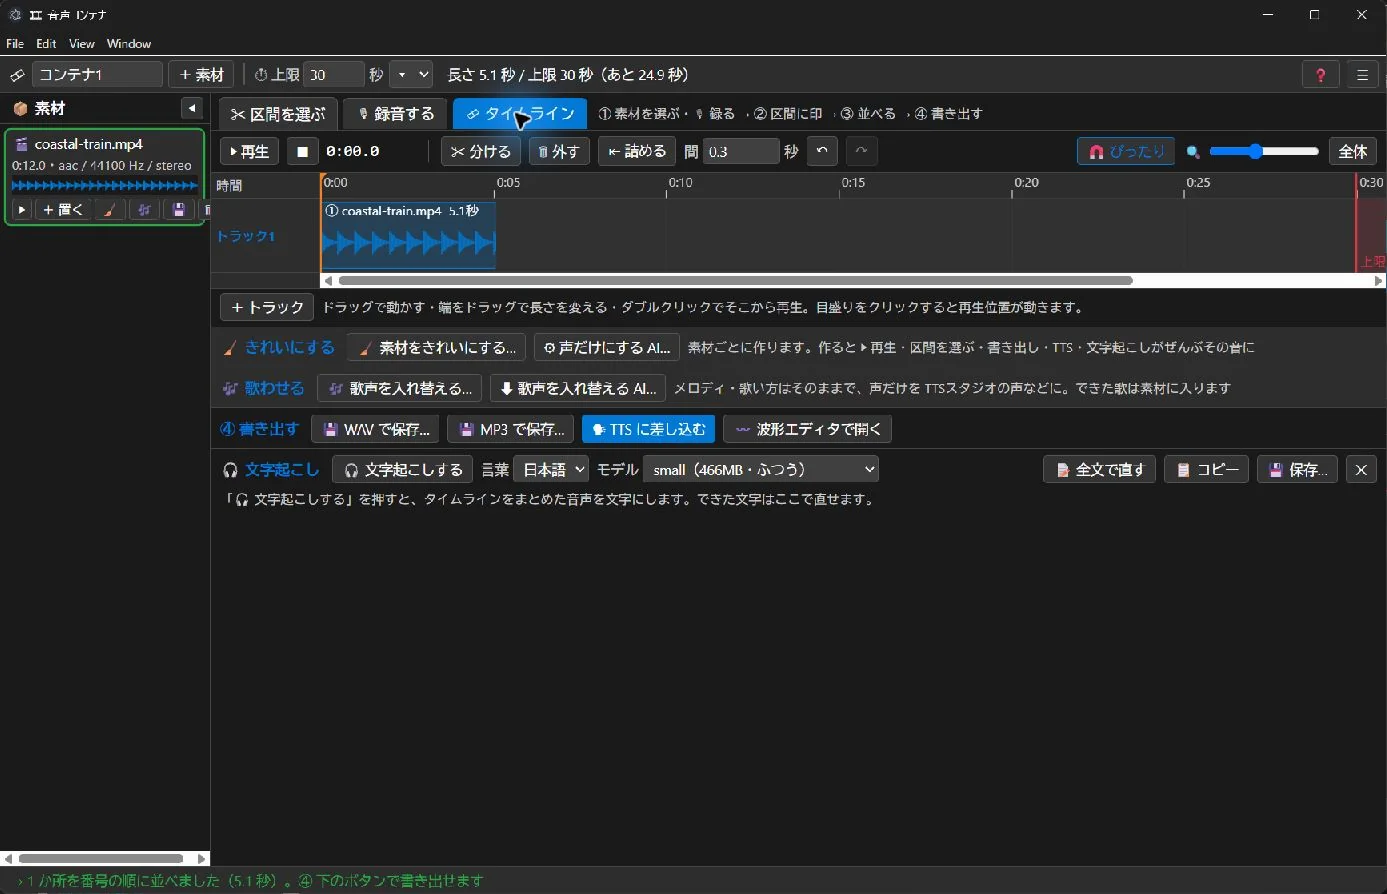
動画のセリフ、録音した声、手元の音声。まず素材として集め、使いたい区間を並べる作業場です。声の分離や変換は、必要になったところで追加できます。
- 素材を入れる音声・動画をドロップ、または「+ 素材」。動画から音声だけをまとめて保存する入口も。
- 区間を選ぶI / Oキーで始点・終点。0.1秒・5秒送り、短い音の試聴、波形の拡大で境目を調整。
- 並べる・重ねる複数トラックへ配置。分割・トリム・隙間詰め・スナップ、クリップごとの音量とフェード。
- 次の道具へ渡すWAV / MP3へ書き出し、波形エディタで仕上げ、TTSスタジオの参照音声へ。
- 録音も素材に
- マイクまたはPCで鳴る音を録音。セリフを1行ずつ表示して録る使い方もあります。キャプチャ対象・権限・デバイスによって利用条件が変わります。
- 書き出し設定
- モノラル / ステレオ、16 / 22.05 / 24 / 44.1 / 48 kHz、MP3は128 / 192 / 256 / 320 kbps。FFmpegが必要です。
- 長さの上限
- 初期値は30秒。10 / 30 / 60 / 120秒、または上限なしを選べます。上限を超えた部分は書き出し時に切られるので、保存前に確認を。TTS側の受け入れ条件とは別です。
- 声と伴奏を分ける
- Demucsで声を分離し、ノイズ低減と組み合わせる入口。分離した音を再生・区間選択・書き出しへ使えます。元の混ざり方によって残響や伴奏が残ります。
- 歌声を入れ替える
- Seed-VCで歌の声質を参照音声へ寄せる工程。伴奏付きならDemucsで分けて重ね直します。歌詞から新しい曲を作曲する機能ではありません。追加環境・モデルの導入と利用条件の確認が必要です。
- 保存・文字起こし
- コンテナの配置や文字起こしを保存して再開。Whisperによる文字起こしの入口もあります。コンテナ保存を元素材の完全なバックアップとは扱わず、素材も保管してください。
声の参照素材は、自分の声か本人の許可を得たものを。利用・公開の範囲まで確認してから使います。公開するときの注意へ →
 実画面を拡大して見る ↗